← 모델 목록
수업 실습 2026-09-04 · image-classification
CNN 계열 (LeNet-5, 합성곱 신경망)

Lenet5 (PyTorch, 논문 구조 직접 구현)

LeNet-5 MNIST 손글씨 숫자 분류 + Grad-CAM (수업 실습)
모델
합성곱 3층 + 완전연결 2층, tanh 활성화로 된 고전 CNN(LeCun 1998). 32×32 흑백 숫자 이미지를 0~9로 분류
사용 목적
논문 구조를 보고 CNN을 직접 구현해 학습하고, TensorBoard 기록과 Grad-CAM으로 모델이 어디를 보고 판단하는지 확인하려고 사용
코드
mnmms/dl
가중치
없음
accuracy98.7%
학습 시간7.6분
추론 CPU / GPU측정 안 함

데이터

  • torchvision MNIST · train 60,000 · test 10,000
  • 32×32로 Resize · Normalize(0.5, 1.0)

학습

  • Adam lr 1e-3 · 배치 32 · 10 에폭
  • GPU(CUDA) · 약 7.6분 (TensorBoard)
  • 파라미터 61,706개

결과

  • test accuracy 0.9871

배운 점

  • conv3 출력은 1×1이라 Grad-CAM은 conv2에 걸어야 함
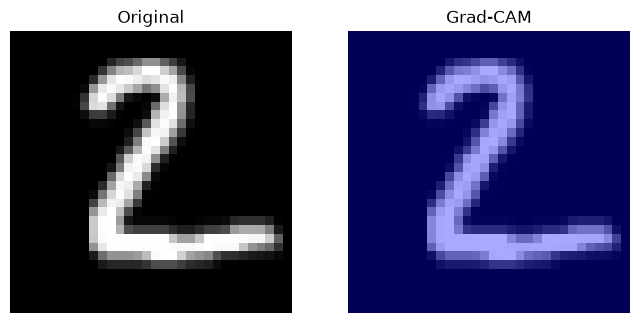
  • Grad-CAM 결과에 강조 영역이 나오지 않음
  • 직접 쓴 숫자 사진은 흑백·색 반전 필요
개요용도 의도한 용도: 논문 구조 그대로 CNN을 구현하고, 학습·평가·Grad-CAM 시각화를 해 보는 수업 실습 대상 사용자:…

용도

  • 의도한 용도: 논문 구조 그대로 CNN을 구현하고, 학습·평가·Grad-CAM 시각화를 해 보는 수업 실습
  • 대상 사용자: 해당 없음 (학습용)
  • 의도하지 않은 용도: 실제 손글씨 인식 서비스

모델 정보

항목 값
베이스 모델 직접 구현 (처음부터 학습)
크기 · 변형 파라미터 61,706개 (torchinfo.summary 출력)
리비전 torch 2.14.0+cu126, torchvision 0.29.0+cu126 (uv.lock 기준)
아키텍처 Conv(1→6, 5×5) → tanh → MaxPool → Conv(6→16, 5×5) → tanh → MaxPool → Conv(16→120, 5×5) → tanh → FC(120→84) → tanh → FC(84→10) → tanh
학습 방식 처음부터 학습
프롬프트 · 에이전트 구성 해당 없음
데이터MNIST 학습 이미지 예시 (숫자 5) 확보 방식 공개 데이터셋 그대로 출처 torchvision.datasets.MNIST…
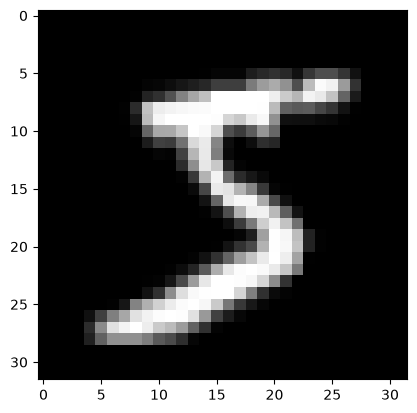
MNIST 학습 이미지 예시 (숫자 5)
항목 값
확보 방식 공개 데이터셋 그대로
출처 torchvision.datasets.MNIST(root='./', download=True)
직접 수집 내용 해당 없음 (Grad-CAM 미션용 직접 쓴 숫자 사진 data/pred.png 1장만 추가)
이용 조건 확인 해당 없음 (공개 데이터셋)
규모 train 60,000 / test 10,000
분할 MNIST 원래 분할. validation 없음
레이블·클래스 분포 숫자 0 ~ 9, 10개 클래스 (MNIST 원본 분포)
전처리 ToTensor → Resize(32) → Normalize((0.5,), (1.0)) (노트북 주석: 정석 값 0.1307 / 0.3081 대신 간이 정규화)
개인정보·민감정보 처리 해당 없음
학습하이퍼파라미터 Adam(lr=1e-3) , CrossEntropyLoss , 배치 32 에폭 / 스텝 10 에폭 (18,750…
항목 값
하이퍼파라미터 Adam(lr=1e-3), CrossEntropyLoss, 배치 32
에폭 / 스텝 10 에폭 (18,750 스텝. TensorBoard에는 10,000 스텝으로 샘플링되어 남음)
학습 시간 약 7.6분 (TensorBoard 로그 12:12:38 ~ 12:20:14)
하드웨어 GPU (cuda:0 출력). 장비는 이 컴퓨터의 NVIDIA GeForce RTX 4070 Laptop GPU 8GB로 보이나 노트북에서 직접 확인하지는 않음 [미확인]
프레임워크 torch 2.14.0+cu126, torchvision 0.29.0, torchinfo, pytorch-grad-cam
시드 · 재현 방법 시드 지정 없음. 노트북을 위에서부터 실행
결과학습 손실 (TensorBoard 스텝별, 200스텝 이동평균) Grad-CAM: 테스트 이미지(숫자 2)에 conv2 기준 …
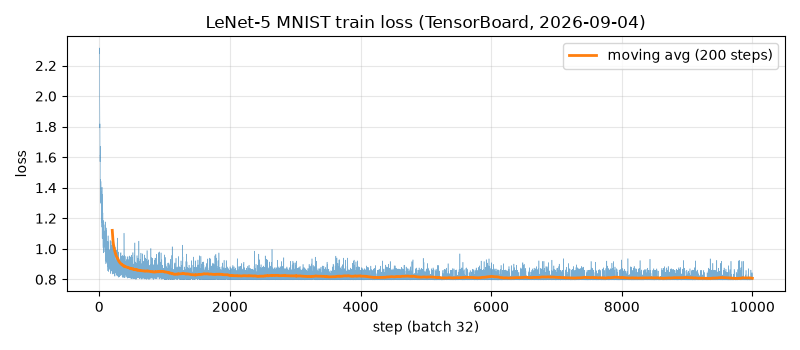
학습 손실 (TensorBoard 스텝별, 200스텝 이동평균)
Grad-CAM: 테스트 이미지(숫자 2)에 conv2 기준 Grad-CAM을 겹친 결과
지표 값 테스트셋 비교 대상 (baseline 등)
accuracy 0.9871 MNIST test 10,000 없음
  • Grad-CAM 결과는 이미지 전체가 같은 파란색으로, 특별히 강조된 영역이 나타나지 않음 (노트북 출력 그림)
  • [🚩AI 설명] 출력층의 tanh가 포화되어 기울기가 거의 0이 되면 Grad-CAM 값이 고르게 0 근처로 나올 수 있습니다. 원인은 확인하지 않았습니다 [미확인]
  • 에폭별 마지막 배치 손실은 0.88 → 0.80에서 멈춤 (노트북 출력)
  • [🚩AI 설명] 출력층 뒤에도 tanh가 있어 로짓이 -1 ~ 1로 묶입니다. 그래서 정확도가 높아도 CrossEntropy 손실이 약 0.8 아래로 내려가지 않은 것으로 보입니다.

추론 성능 (CPU / GPU)

측정 안 함.

장비 장비 이름 배치 크기 지연 시간 (샘플당, p50 / p95) 처리량 (샘플/초) 메모리 사용
CPU [미확인] - 측정 안 함 측정 안 함 측정 안 함
GPU [미확인] - 측정 안 함 측정 안 함 측정 안 함
한계 · 배운 점한계 알려진 실패 유형: [미확인] (틀린 테스트 이미지를 따로 보지 않음) 편향 / 공정성 이슈: 해당 없음 성능이 떨어지는…

한계

  • 알려진 실패 유형: [미확인] (틀린 테스트 이미지를 따로 보지 않음)
  • 편향 / 공정성 이슈: 해당 없음
  • 성능이 떨어지는 입력 조건: 흰 종이에 검은 펜으로 쓴 사진 (MNIST는 검은 배경 + 흰 글씨라 반전 필요, 노트북 주석)

배운 점

  • 이미지 텐서는 [채널, H, W], DataLoader를 거치면 [배치, 채널, H, W] 4차원. 한 장을 추론할 때는 unsqueeze(0)로 배치 차원을 추가 (노트북 주석)
  • conv3 출력이 [120, 1, 1]이라 공간 정보가 없어 Grad-CAM은 그 앞의 conv2([16, 10, 10])에 걸어야 함 (노트북 주석)
  • Grad-CAM 대상(target)은 정답이 아니라 모델이 예측한 클래스, 그리고 no_grad() 밖에서 계산 (노트북 주석)
  • 노트북 메모: "분류모델에서 Grad-CAM이 안 들어간다? 말이 안 됨"
사용 방법코드 셀 4개
In [1]데이터 준비
data__transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Resize(32),
    transforms.Normalize((0.5,), (1.0))
])
train_data = datasets.MNIST(root='./', train=True, transform=data__transform, download=True)
test_data = datasets.MNIST(root='./', train=False, transform=data__transform, download=True)

train_loader = DataLoader(train_data, batch_size=32, shuffle=True)
test_loader = DataLoader(test_data, batch_size=32)
In [2]학습 (TensorBoard 기록)
model.to(device)
epochs = 10
optim = Adam(model.parameters(), lr=1e-3)
ciriterion = nn.CrossEntropyLoss()
writer = SummaryWriter()

count = 0
for epoch in range(epochs):
    for data, label in train_loader:
        optim.zero_grad()
        pred = model(data.to(device))
        loss = ciriterion(pred, label.to(device))
        writer.add_scalar('Loss/train', loss, count)
        count += 1
        loss.backward()
        optim.step()
    print(f'epoch: {epoch+1} / loss: {loss.item()}')
Out[2] 출력 보기
epoch: 1 / loss: 0.8837156295776367
epoch: 2 / loss: 0.8420839905738831
...
epoch: 10 / loss: 0.7967485189437866
In [3]평가
model.eval()
total_corr = 0
with torch.no_grad():
    for images, labels in test_loader:
        preds = model(images.to(device))
        _, pred = torch.max(preds.data, 1)
        total_corr += (pred == labels.to(device)).sum().item()
    print(f'acc: {total_corr/len(test_data.targets)}')
Out[3] 출력 보기
acc: 0.9871
In [4]Grad-CAM
from pytorch_grad_cam import GradCAM
from pytorch_grad_cam.utils.image import show_cam_on_image
from pytorch_grad_cam.utils.model_targets import ClassifierOutputTarget

ca = GradCAM(model=model, target_layers=[model.conv2])

image, _ = test_data[1]
input_tensor = image.unsqueeze(0).to(device)
pred_class = model(input_tensor).argmax().item()

grayscale_cam = ca(input_tensor=input_tensor, targets=[ClassifierOutputTarget(pred_class)])
같은 과제·데이터셋 비교

같은 과제·데이터셋으로 학습한 모델이 생기면 여기에서 비교됩니다.