In [1]측정 + TensorBoard 기록
.\.venv\Scripts\python.exe analysis\stand_bg_removal_category_tensorboard\log_stand_bg_removal_category_to_tensorboard.py --catalog-per-label 799 --per-label 112 --seed 0| 항목 | 값 |
|---|---|
| 베이스 모델 | CLIP ViT-B-32-quickgelu (open_clip, pretrained=openai), DINOv3 facebook/dinov3-vitl16-pretrain-lvd1689m, PiDiNet table5_pidinet (체크포인트 analysis/pidinet/trained_models/table5_pidinet.pth), 배경 제거 rembg u2net |
| 크기 · 변형 | CLIP ViT-B/32, DINOv3 ViT-L/16 (파라미터 수 [미확인]) |
| 리비전 | Hugging Face revision은 지정하지 않음 ([미확인]). rembg 2.0.84, transformers 5.17.0 (프로젝트 .venv) |
| 아키텍처 | 손그림 → CLIP 임베딩(상품은 PiDiNet 스케치화 0.8 + 원본 0.2 혼합) 과 DINOv3 임베딩(상품은 원본 사진). 점수 = 0.3 × CLIP + 0.7 × DINOv3 코사인 유사도 |
| 학습 방식 | 학습하지 않음. 사전학습 가중치와 가중합(DINOV3_WEIGHT=0.7, RAW_WEIGHT=0.2)만 사용 |
| 프롬프트 · 에이전트 구성 | 해당 없음 |
비교한 세 구성 (②, ③은 누적이 아니라 각각 ①에 하나씩만 더함):
| run | 구성 | 내용 |
|---|---|---|
1_final (r1) |
최종 모델 | 원본 사진, 카테고리 분리 없음 |
2_final_rembg (r2) |
+ 배경 제거 | DINOv3 갈래의 상품 사진만 rembg 배경 제거 + 피사체 크롭 |
3_final_category (r3) |
+ 카테고리 분리 | 장 손그림은 장스탠드 안에서만, 단 손그림은 단스탠드 안에서만 검색. 배경 제거 없음 |
| 항목 | 값 |
|---|---|
| 확보 방식 | 직접 수집 (상품 사진) + 직접 그린 손그림 |
| 출처 | 오늘의집 조명 상품 (data/ohou_lighting_products_stand_labeled.csv, 장/단 라벨 포함). 손그림은 data/hand_sketch_targets/ |
| 직접 수집 내용 | 오늘의집 공식 API가 없어 브라우저 콘솔 스크립트로 수집. 열어 둔 카테고리·검색 결과 페이지에서 스크롤하며 DOM의 상품 정보(product_id, name, brand, price, link, image_url)를 읽어 JSON으로 저장(analysis/ohou_browser_collect/category_collect.js, search_collect.js). 이 JSON을 Claude 스킬(ohou-collect)이 읽어 중복 제거 후 이미지를 내려받고 CSV(data/ohou_lighting_products.csv)로 만듦. 수집 기간·장/단 라벨링 방법은 [미확인] |
| 이용 조건 확인 | [미확인] (오늘의집 이용약관·robots.txt 확인 여부를 확인하지 않음) |
| 규모 | 라벨된 상품 약 2,375개 (CSV 2,376줄, 헤더 포함). 이 측정에서는 카탈로그 장 799 + 단 799개 사용. 손그림 파일 269개 중 쿼리 224장 |
| 분할 | 학습 없음. 쿼리 장 112 + 단 112 = 224장. 카탈로그는 손그림 정답 상품을 반드시 포함하고 나머지는 seed 고정 무작위 |
| 레이블·클래스 분포 | 장스탠드 / 단스탠드 1 : 1 (카탈로그·쿼리 모두). ①②의 검색 후보는 장+단을 섞은 799개 (장 400 + 단 399), ③은 같은 라벨 799개 |
| 전처리 | 손그림 정제 + 크롭, 상품 사진 PiDiNet 스케치화(CLIP 갈래), 원본 사진(DINOv3 갈래), ②는 rembg + 피사체 bbox 크롭 |
| 개인정보·민감정보 처리 | 해당 없음 (상품 사진과 손그림) |
학습을 하지 않았으므로 하이퍼파라미터·에폭·학습 시간은 해당 없음입니다.
| 항목 | 값 |
|---|---|
| 하이퍼파라미터 | 해당 없음 (측정 설정: Top-K=10, 모양 무관 기준 = 유사도 하위 50%, 최악 사례 = 오답 50% 이상) |
| 에폭 / 스텝 | 해당 없음 |
| 학습 시간 | 해당 없음. 임베딩 캐시를 처음 만들 때 약 35분 (README.md 안내, 직접 재지 않음) |
| 하드웨어 | 측정에 쓴 장비 [미확인] (코드는 CUDA가 있으면 GPU, 없으면 CPU를 쓰며 torch 2.11.0+cu128이 설치됨) |
| 프레임워크 | PyTorch 2.11.0+cu128, transformers 5.17.0, open_clip, rembg 2.0.84, TensorBoard 2.21.0, Python 3.12 (.venv) |
| 시드 · 재현 방법 | seed=0. 프로젝트 루트에서 .\analysis\stand_bg_removal_category_tensorboard\run_stand_bg_removal_category_tensorboard.ps1 (--catalog-per-label 799 --per-label 112 --mixed-size 799 --seed 0) |
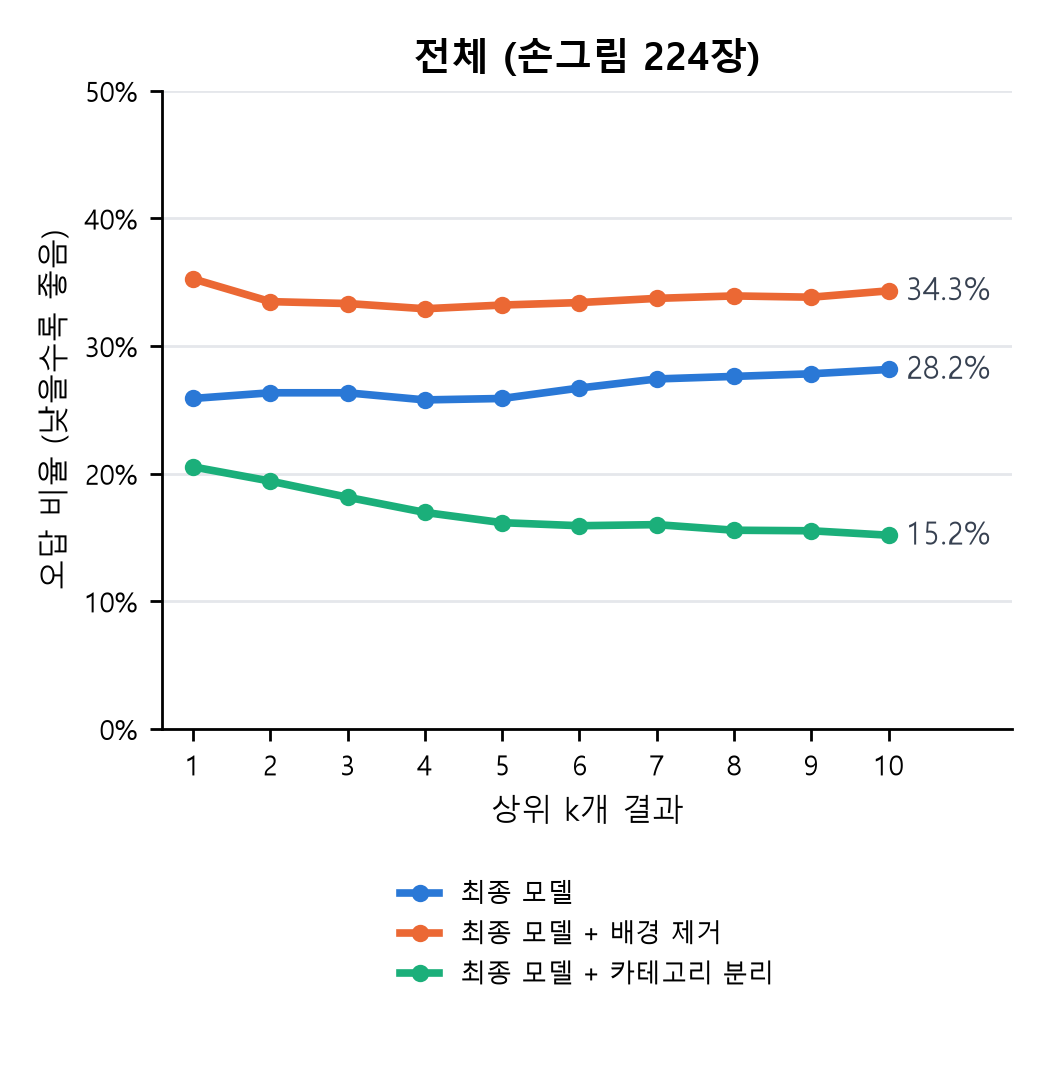
오답은 Top-10 결과(정답 자신 제외) 하나하나가 ⓐ 장↔단 혼동(라벨이 손그림과 다름) 또는 ⓑ 같은 라벨이지만 정답 상품과의 유사도가 카탈로그 하위 50%(모양 무관)에 해당하는 경우입니다. 오답률 = Top-10 중 오답 비율(낮을수록 좋음)이고, 정답률은 참고용입니다.
| 지표 | 최종 모델 (r1) | + 배경 제거 (r2) | + 카테고리 분리 (r3) | 테스트셋 |
|---|---|---|---|---|
| 오답률 (전체) | 28.2% (24~32%) | 34.3% (31~38%) | 15.2% (12~18%) | 손그림 224장 |
| ⓐ 장↔단 혼동 | 17.9% | 25.1% | 0.0% (설계상) | 〃 |
| ⓑ 같은 라벨·모양 무관 | 10.2% | 9.2% | 15.2% | 〃 |
| 1등이 오답 | 25.9% | 35.3% | 20.5% | 〃 |
| 오답 5개↑ 손그림 비율 | 25.9% | 31.2% | 11.6% | 〃 |
| 오답률 (장스탠드) | 28.9% | 23.6% | 21.5% | 장 112장 |
| 오답률 (단스탠드) | 27.4% | 45.1% | 8.8% | 단 112장 |
| 장/단 오답률 차이 | 1.5%p | 21.5%p | 12.7%p | 224장 |
| (참고) 정답률 Top-10 | 44.2% | 52.2% | 39.3% | 224장 |
괄호는 부트스트랩 95% CI입니다. 최종 모델과 같은 손그림끼리 짝지은 차이:
| 비교 | Δ오답률 | Δ장↔단 혼동 | Δ같은 라벨·모양 무관 | (참고) Δ정답률 |
|---|---|---|---|---|
| + 배경 제거 − 최종 모델 | +6.2%p (+3.4~+8.8) | +7.2%p (+4.6~+9.7) | −1.0%p (−2.7~+0.7) | +8.0%p (+1.3~+14.7) |
| + 카테고리 분리 − 최종 모델 | −13.0%p (−15.8~−10.1) | −17.9%p (−21.2~−14.8) | +5.0%p (+3.4~+6.7) | −4.9%p (−8.5~−2.2) |
cat799_mixall_q112_seed0)에서도 방향은 같음: 오답률 최종 모델 29.0% / + 배경 제거 33.5% / + 카테고리 분리 15.2% (summary.md)측정 안 함. 이 분석은 오답률 비교이며 지연 시간·처리량·메모리는 재지 않았습니다. infer_ms에는 넣지 않았습니다.
| 장비 | 장비 이름 | 배치 크기 | 지연 시간 (샘플당, p50 / p95) | 처리량 (샘플/초) | 메모리 사용 |
|---|---|---|---|---|---|
| CPU | - | - | 측정 안 함 | 측정 안 함 | 측정 안 함 |
| GPU | - | - | 측정 안 함 | 측정 안 함 | 측정 안 함 |
같은 모델을 설정·분류기를 바꿔 3번 측정한 기록입니다. ★ r3이(가) 대표 결과(맨 위 수치)입니다.
| 실행 | 날짜 | 바뀐 점 | background | category_separation | candidates | off_rate | cat_wrong_rate | hit_top10 | 학습 시간 |
|---|---|---|---|---|---|---|---|---|---|
| r1 최종 모델 | 2026-09-29 | 기준: 원본 사진, 카테고리 분리 없음analysis/stand_bg_removal_category_tensorboard/runs/cat799_mix799_q112_seed0/ | original | false | 799 | 28.2% | 17.9% | 44.2% | - |
| r2 + 배경 제거 | 2026-09-29 | DINOv3 갈래 상품 사진에 rembg 배경 제거 + 피사체 크롭analysis/stand_bg_removal_category_tensorboard/runs/cat799_mix799_q112_seed0/ | rembg | false | 799 | 34.3% | 25.1% | 52.2% | - |
| ★ r3 + 카테고리 분리 | 2026-09-29 | 배경 제거 없이, 손그림과 같은 라벨(장/단) 상품 안에서만 검색analysis/stand_bg_removal_category_tensorboard/runs/cat799_mix799_q112_seed0/ | original | true | 799 | 15.2% | 0.0% | 39.3% | - |
본문에 넣지 않은 그림 2장입니다. 누르면 크게 보입니다.
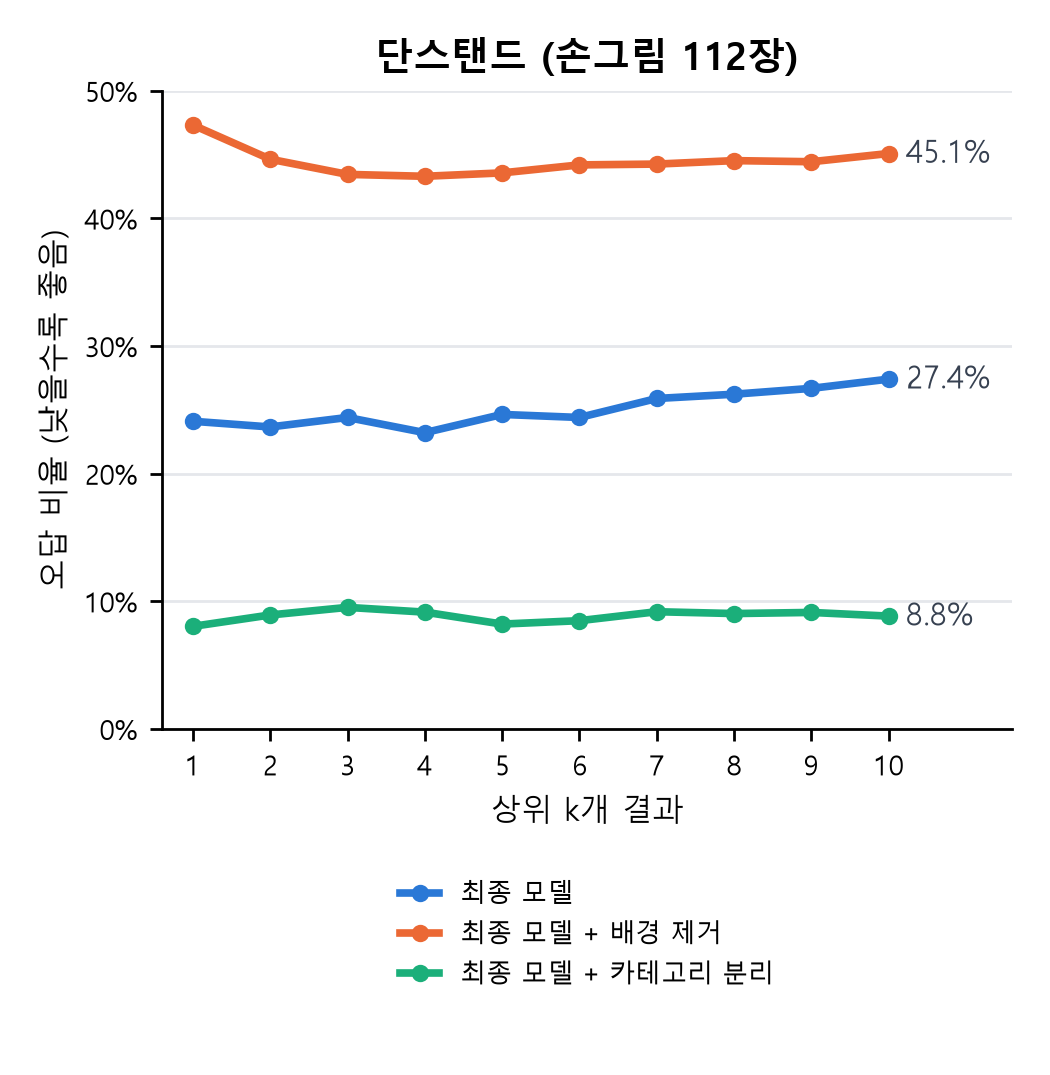
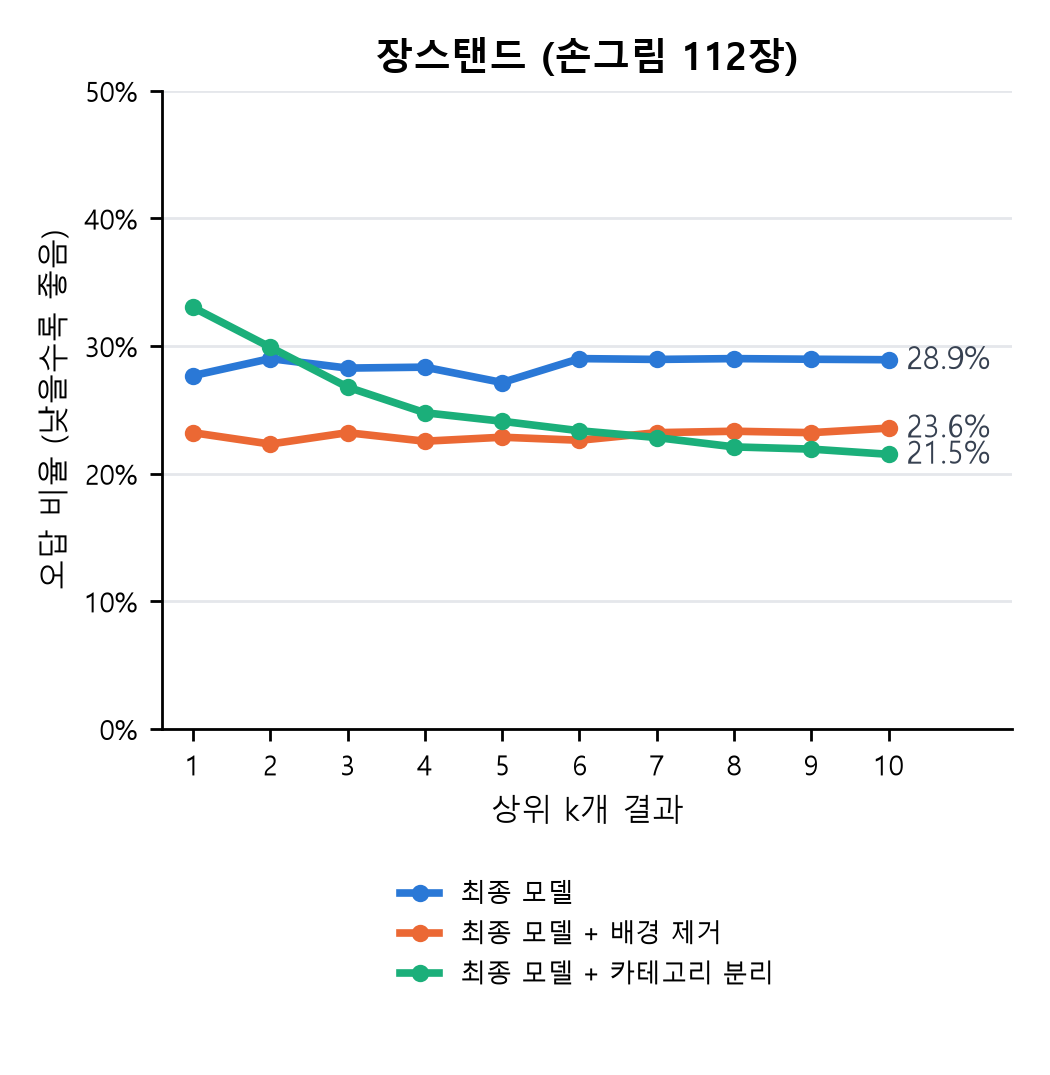
.\.venv\Scripts\python.exe analysis\stand_bg_removal_category_tensorboard\log_stand_bg_removal_category_to_tensorboard.py --catalog-per-label 799 --per-label 112 --seed 0.\.venv\Scripts\python.exe -m tensorboard.main --logdir analysis\stand_bg_removal_category_tensorboard\runs같은 과제·데이터셋으로 학습한 모델이 생기면 여기에서 비교됩니다.