← 모델 목록
수업 실습 2026-10-07 · image-text-matching
SigLIP 계열 (sigmoid 손실 이미지-텍스트 모델)

google/siglip2-base-patch16-224

SigLIP2 base 이미지-텍스트 매칭 (수업 실습)
모델
CLIP과 같은 이미지-텍스트 임베딩 모델로, softmax 대신 sigmoid 손실로 학습한 Google의 SigLIP 2 (base, patch16, 224px)
사용 목적
CLIP과 같은 실습(zero-shot 분류, 텍스트로 이미지 검색)을 SigLIP2로 해 보고 점수 계산 방식 차이를 익히려고 사용
코드
mnmms/data-analysis
가중치
siglip2-base-patch16-224 1.5GB · HF Hub
학습 시간없음
추론 CPU / GPU측정 안 함

데이터

  • 추론만 · 분류 이미지 1장 (COCO val2017)
  • 검색 대상 옷 이미지 5장 (images/clothes)

학습

  • 학습 없음 · 사전학습 가중치
  • GPU RTX 4070 Laptop · device_map=auto

결과

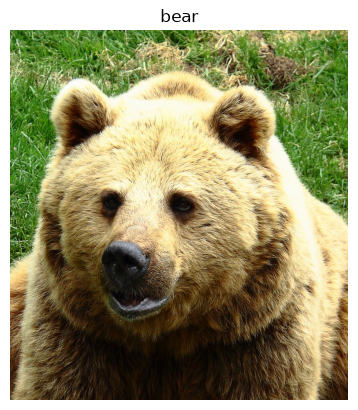
  • 분류: bear 점수 0.189 (rabbit · dog ≈ 1e-6)
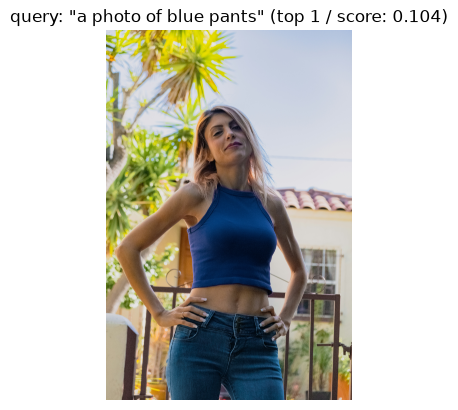
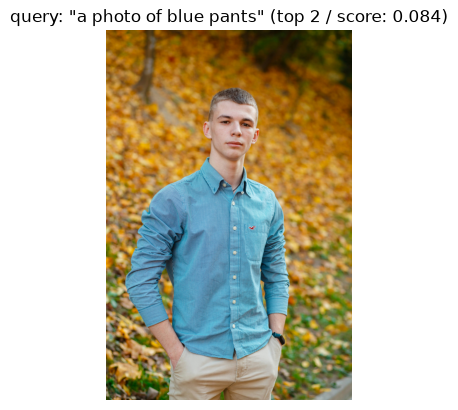
  • 검색 "a photo of blue pants" Top-2 = image2 · image5 (예상 image1 · image2와 다름)
  • 정량 지표 없음

배운 점

  • sigmoid라 점수 합이 1이 아니어도 정상
  • 텍스트는 max_length=64로 패딩해야 함 (학습 때 그렇게 학습)
  • transformers 5 이상은 get_*_features().pooler_output
개요용도 의도한 용도: 텍스트 라벨로 이미지를 분류(zero-shot)하고 텍스트로 이미지 폴더를 검색하는 실습을 SigLIP2로…

용도

  • 의도한 용도: 텍스트 라벨로 이미지를 분류(zero-shot)하고 텍스트로 이미지 폴더를 검색하는 실습을 SigLIP2로 해 보며 CLIP과 다른 점(sigmoid, 벡터화 함수)을 익히기
  • 대상 사용자: 해당 없음 (학습용)
  • 의도하지 않은 용도: 정확도 근거로서의 모델 선정. 정답 라벨로 평가하지 않았고 이미지가 1장(분류), 5장(검색)뿐임. 분류 모델이 아니라 임베딩 모델이라 "분류기"라고만 부르면 틀림 (노트북 정리)

모델 정보

항목 값
베이스 모델 Hugging Face google/siglip2-base-patch16-224 (AutoModel, AutoProcessor)
크기 · 변형 base, patch 16, 입력 224×224 (노트북 메모: patch가 작으면 촘촘히, 크면 넓게 봄). 가중치 파일 model.safetensors 1.50GB, 텐서 408개. 파라미터 수 [미확인]
리비전 revision은 지정하지 않음 ([미확인]). transformers 5.19.0
아키텍처 이미지 인코더(ViT) + 텍스트 인코더(Transformer), 분류 헤드 없음. logits = scale × (정규화 이미지 임베딩 @ 정규화 텍스트 임베딩ᵀ) + bias. 세부 차원은 [미확인]
학습 방식 학습하지 않음. 사전학습 가중치로 추론만
프롬프트 · 에이전트 구성 분류 라벨 3개: "bear", "rabbit", "dog". 검색 질의: "a photo of blue pants" (top_k=2). 처음에는 "a blue pants"로 했다가 바꿈
데이터학습·평가 데이터셋은 없고, 추론에 쓴 입력만 있습니다. 확보 방식 공개 이미지 1장 + 수업 자료 이미지 (추론만) 출처 분…

학습·평가 데이터셋은 없고, 추론에 쓴 입력만 있습니다.

항목 값
확보 방식 공개 이미지 1장 + 수업 자료 이미지 (추론만)
출처 분류: https://huggingface.co/datasets/merve/coco/resolve/main/val2017/000000000285.jpg (COCO val2017). 검색: 로컬 images/clothes/image1~5.jpg (원출처·저작권 [미확인])
직접 수집 내용 해당 없음
이용 조건 확인 [미확인] (COCO 이용 조건·옷 이미지 원출처 확인 안 함)
규모 분류 이미지 1장 + 라벨 3개 / 검색 대상 이미지 5장 + 질의 1개
분할 해당 없음
레이블·클래스 분포 해당 없음 (라벨은 텍스트 3개를 직접 지정)
전처리 AutoProcessor가 리사이즈·정규화, 텍스트는 max_length=64로 패딩. 이미지·텍스트 벡터 모두 F.normalize로 L2 정규화. 이미지는 .convert("RGB")로 변환
개인정보·민감정보 처리 해당 없음 (동물 사진, 옷 사진)
학습학습을 하지 않았으므로 하이퍼파라미터·에폭·학습 시간은 해당 없음 입니다. 하이퍼파라미터 해당 없음 (추론 설정: 분류·검색 …

학습을 하지 않았으므로 하이퍼파라미터·에폭·학습 시간은 해당 없음입니다.

항목 값
하이퍼파라미터 해당 없음 (추론 설정: 분류·검색 텍스트 모두 padding="max_length", max_length=64, truncation=True, torch.no_grad())
에폭 / 스텝 해당 없음
학습 시간 해당 없음
하드웨어 GPU (device = cuda, device_map="auto", 이 컴퓨터의 NVIDIA GeForce RTX 4070 Laptop 8188MiB)
프레임워크 transformers 5.19.0, huggingface-hub 1.33.0, PyTorch 2.14.1+cu126 (uv.lock 기준)
시드 · 재현 방법 노트북을 위에서부터 실행. 분류 이미지는 URL에서 받음 (네트워크 필요)
결과분류 결과: bear Top-1: image2 Top-2: image5 정량 지표 없음. 정답 라벨로 정확도를 재지 않고 점수…
분류 결과: bear
분류 결과: bear
Top-1: image2
Top-1: image2
Top-2: image5
Top-2: image5

정량 지표 없음. 정답 라벨로 정확도를 재지 않고 점수와 순위를 눈으로만 확인했습니다.

실습 입력 결과 비교 대상
분류 (sigmoid) COCO val2017 이미지, 라벨 bear · rabbit · dog bear 0.1892 · rabbit 1.5e-6 · dog 4.7e-6 → bear (점수 합 0.189) 해당 없음
검색 (코사인 유사도) "a photo of blue pants", 이미지 5장 image1 0.0665 · image2 0.1045 · image3 0.0060 · image4 0.0613 · image5 0.0837 → Top-2 = image2, image5 해당 없음

검색 결과 (질의 "a photo of blue pants", 그림 제목에 점수 표시):

예상과 비교 (노트북 "결과" 셀 메모): 직접 본 이미지 설명 기준으로 예상 Top-2는 image1(흰 티에 어두운 청색 반바지), image2(파란 크롭탑에 청바지)였지만, 실제는 image2, image5(하늘색 셔츠에 베이지 바지)였습니다. 노트북에는 상/하의 구분 없이 색과 옷 종류를 같이 보기 때문으로 정리했습니다(원인 검증은 하지 않음). 점수 차이가 작아(0.0665~0.1045) 순위가 질의 표현에 쉽게 바뀔 수 있고, 개선 방법으로 질의를 구체적으로 쓰거나 바지만 보이게 크롭하는 것을 적었습니다.

추론 성능 (CPU / GPU)

측정 안 함. 지연 시간·처리량·메모리를 재는 코드가 노트북에 없습니다. infer_ms는 넣지 않았습니다.

장비 장비 이름 배치 크기 지연 시간 (샘플당, p50 / p95) 처리량 (샘플/초) 메모리 사용
CPU [미확인] - 측정 안 함 측정 안 함 측정 안 함
GPU NVIDIA GeForce RTX 4070 Laptop 8GB 1 측정 안 함 측정 안 함 측정 안 함
한계 · 배운 점한계 알려진 실패 유형: 정답으로 보이는 bear 의 점수도 0.189로 낮았음. 프롬프트 문구를 바꿔 비교하지 않음 ( [미…

한계

  • 알려진 실패 유형: 정답으로 보이는 bear의 점수도 0.189로 낮았음. 프롬프트 문구를 바꿔 비교하지 않음 ([미확인]). [🚩AI 설명] sigmoid 점수는 각 라벨의 독립 확률이라 프롬프트 문구("a photo of a bear" 등)에 따라 달라질 수 있음
  • 검색 결과가 예상과 다름: 질의에 맞는 바지가 있는 image1이 Top-2에 못 들었음. [🚩AI 설명] 이미지 5장뿐이라 일반화는 불가
  • 코드 수정 이력: 처음에는 trancation 오타, 검색 텍스트 padding 누락, 텍스트 벡터 미정규화(점수가 코사인 아닌 내적, 질의 "a blue pants" Top-2 = image1·image4)였으나 노트북에서 모두 고쳐 다시 실행함. 고친 뒤 결과가 바뀜 (결과가 바뀐 원인은 텍스트 벡터 정규화와 오타 수정이라고 직접 확인함, 사용자 확인)
  • 로드 경고: 모델 config의 bos_token_id·eos_token_id(49406·49407)가 어휘 범위(0~31999)를 벗어난다는 transformers 경고가 출력됨. 결과에 미친 영향은 [미확인]
  • 이미지 벡터화 셀이 processor(text=classes, images=...)로 불필요하게 텍스트(classes)까지 처리함 (결과에는 영향 없음)
  • 편향 / 공정성 이슈: [미확인]
  • 성능이 떨어지는 입력 조건: [미확인] (이미지 1장, 5장만 확인)

배운 점

  • SigLIP2 텍스트는 항상 max_length=64까지 패딩한 상태로 학습되어 있어, 검색 질의에도 padding="max_length"를 써야 한다 (노트북 메모)
  • 제로샷 분류는 클래스를 학습 때 고정하지 않고 추론 때 텍스트로 지정한다. 클래스 추가·변경이 프롬프트 수정만으로 되지만 과제에 특화한 지도학습 분류보다 정확도는 대체로 낮다
  • SigLIP2는 분류 헤드가 없는 이미지-텍스트 임베딩 모델이다. 사전학습 가중치로 추론만 하면 "제로샷 분류"로 쓴 것이다
  • CLIP은 softmax로 라벨끼리 확률을 나누고(합 = 1), SigLIP2는 sigmoid로 이미지-텍스트 쌍마다 독립적인 "맞다/아니다" 점수를 낸다. 합이 1이 아니어도 정상이고 모든 라벨이 낮게 나올 수도 있다
  • 벡터화 함수가 다르다: CLIP은 vision_model → visual_projection → 정규화, SigLIP2는 get_image_features(...) → 정규화. transformers 5 이상은 .pooler_output을 붙여야 한다
  • [🚩AI 설명] 같은 질의와 이미지 묶음으로 CLIP과 비교하지 않아(질의가 다름: "a black shirt" vs "a photo of blue pants") 성능 차이는 말할 수 없다
  • [🚩AI 설명] 다음에 해 볼 것: 같은 이미지·같은 질의로 CLIP과 SigLIP2의 Top-k와 속도 비교
사용 방법코드 셀 4개
In [1]모델 불러오기
import torch
from transformers import AutoModel, AutoProcessor
from transformers.image_utils import load_image

device = "cuda" if torch.cuda.is_available() else "cpu"

ckpt = "google/siglip2-base-patch16-224"
model = AutoModel.from_pretrained(ckpt, device_map="auto").eval()
processor = AutoProcessor.from_pretrained(ckpt)
Out[1] 출력 보기
cuda
Loading weights:   0%|          | 0/408 [00:00<?, ?it/s]
In [2]zero-shot 분류
image = load_image("https://huggingface.co/datasets/merve/coco/resolve/main/val2017/000000000285.jpg")
classes = ["bear", "rabbit", "dog"]

inputs = processor(
    text=classes,
    images=[image],
    return_tensors="pt",
    padding="max_length",
    max_length=64,
    truncation=True,
).to(device)

with torch.no_grad():
    outputs = model(**inputs)
    logits_per_image = outputs.logits_per_image
    scores = torch.sigmoid(logits_per_image).to("cpu")
    print(scores)
    print(scores.sum().item())

print(classes[scores[0].argmax()])
Out[2] 출력 보기
tensor([[1.8920e-01, 1.5240e-06, 4.6808e-06]])
0.18920376896858215
bear
In [3]이미지 폴더 벡터화
import torch.nn.functional as F
from PIL import Image

image_features = []
for file_path in file_path_list:  # images/clothes 안의 jpg·png 5장
    image = Image.open(file_path).convert("RGB")
    inputs = processor(images=[image], return_tensors="pt").to(device)
    with torch.no_grad():
        feature = model.get_image_features(**inputs).pooler_output  # transformers 5 이상은 pooler_output
        feature = F.normalize(feature, p=2, dim=-1)
    image_features.append(feature.to("cpu"))

image_features = torch.cat(image_features, dim=0)
In [4]텍스트 질의로 검색
query = "a photo of blue pants"
top_k = 2

inputs = processor(
    text=[query],
    return_tensors="pt",
    padding="max_length",  # SigLIP2는 텍스트를 max_length=64까지 패딩한 상태로 학습
    max_length=64,
    truncation=True,
).to(device)

with torch.no_grad():
    text_feature = model.get_text_features(**inputs).pooler_output
    text_feature = F.normalize(text_feature, p=2, dim=-1)

similarity = (image_features @ text_feature.to("cpu").T).squeeze(1)
top_indices = similarity.argsort(descending=True)[:top_k]
print(similarity)
print(top_indices)
Out[4] 출력 보기
tensor([0.0665, 0.1045, 0.0060, 0.0613, 0.0837])
tensor([1, 4])

같은 과제·데이터셋 비교

같은 과제·데이터셋으로 학습한 모델이 생기면 여기에서 비교됩니다.