In [1]데이터 불러오기·나누기
import pandas as pd
from sklearn.model_selection import train_test_split
from catboost import CatBoostClassifier

df = pd.read_excel('./data/customer_churn_classification_dataset.xlsx')
X = df.drop(columns=["CustomerID", "Churn"])
y = df["Churn"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42, stratify=y)

categorical_cols = X.select_dtypes(include=['object', 'category']).columns.tolist()
categorical_cols
Out[1] 출력 보기
['Gender', 'Region', 'ContractType', 'PaymentMethod', 'AutoPay', 'PremiumPlan']
In [2]범주형을 직접 넣어 학습하기
cat_model = CatBoostClassifier(
    iterations=300,
    learning_rate=0.05,
    depth=6,
    loss_function='Logloss',
    random_state=42,
    verbose=0
)
cat_model.fit(X_train, y_train, cat_features=categorical_cols)
In [3]임계값 0.3으로 예측하기
pred_cat = cat_model.predict_proba(X_test)[:, 1]
threshold = 0.3
pred = (pred_cat >= threshold).astype(int)
In [4]지표 확인하기
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score, roc_auc_score, confusion_matrix

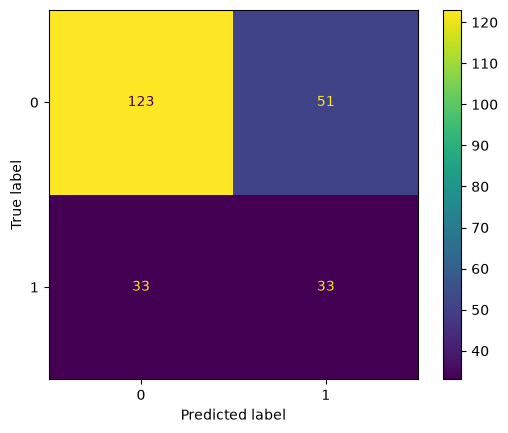
print(confusion_matrix(y_test, pred))
print('Accuracy : ', accuracy_score(y_test, pred))
print('Precision : ', precision_score(y_test, pred))
print('Recall : ', recall_score(y_test, pred))
print('F1 Score : ', f1_score(y_test, pred))
print('ROC-AUC : ', roc_auc_score(y_test, pred))
Out[4] 출력 보기
[[123  51]
 [ 33  33]]
Accuracy :  0.65
Precision :  0.39285714285714285
Recall :  0.5
F1 Score :  0.44
ROC-AUC :  0.603448275862069