In [1]결측·이상치 처리
df['Thumbnail_Score'] = df['Thumbnail_Score'].fillna(df['Thumbnail_Score'].median())
df['Avg_Watch_Percent'] = df['Avg_Watch_Percent'].fillna(df['Avg_Watch_Percent'].median())

outlier_cols = ['Channel_Subscribers', 'First24h_Views', 'First24h_Likes', 'First24h_Comments']
for col in outlier_cols:
    lower = df[col].quantile(0.01)
    upper = df[col].quantile(0.99)
    df[col] = df[col].clip(lower, upper)
In [2]카테고리 원-핫·데이터 나누기
from sklearn.preprocessing import OneHotEncoder

encoder = OneHotEncoder(handle_unknown='ignore', sparse_output=False)
X_encoded = encoder.fit_transform(df[['Category']])
encoded_df = pd.DataFrame(X_encoded, columns=encoder.get_feature_names_out(['Category']))

df = df.drop(columns=['Video_ID', 'Category'])
df = pd.concat([df, encoded_df], axis=1)

X = df.drop(columns=['Seven_Day_Views'])
y = df["Seven_Day_Views"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
print(X_train.shape, X_test.shape)
Out[2] 출력 보기
(1200, 21) (300, 21)
In [3]학습·평가 (r1)
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, root_mean_squared_error, r2_score

model = LinearRegression()
model.fit(X_train, y_train)
pred = model.predict(X_test)

print(f"mae: {mean_absolute_error(y_test, pred)}")
print(f"rmse: {root_mean_squared_error(y_test, pred)}")
print(f"r2score: {r2_score(y_test, pred)}")
Out[3] 출력 보기
mae: 13424.07833434806
rmse: 28080.873476833556
r2score: 0.8563177368381205
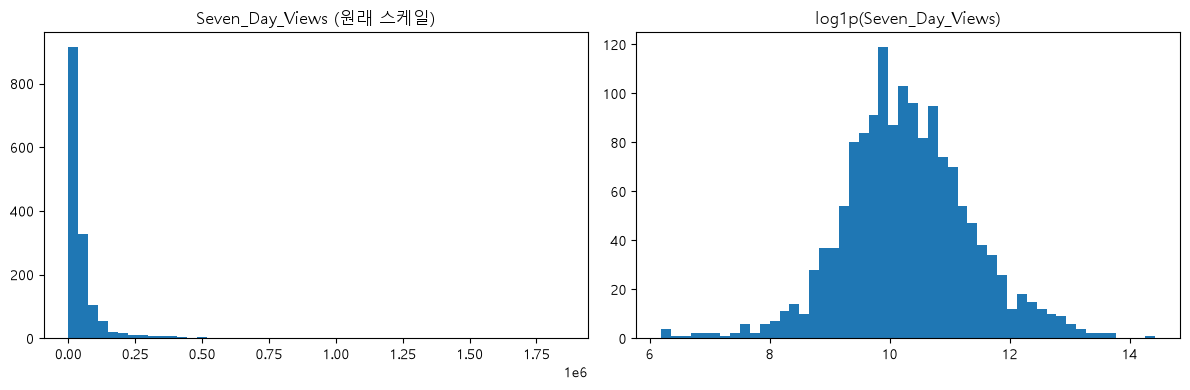
In [4]log1p 타깃 실험 (r2)
import numpy as np

y_train_log = np.log1p(y_train)
log_model = LinearRegression()
log_model.fit(X_train, y_train_log)
log_pred = np.expm1(log_model.predict(X_test))

print(f"mae: {mean_absolute_error(y_test, log_pred)}")
print(f"rmse: {root_mean_squared_error(y_test, log_pred)}")
print(f"r2score: {r2_score(y_test, log_pred)}")
Out[4] 출력 보기
mae: 48950.97589049459
rmse: 232296.95978402696
r2score: -8.83261391215422