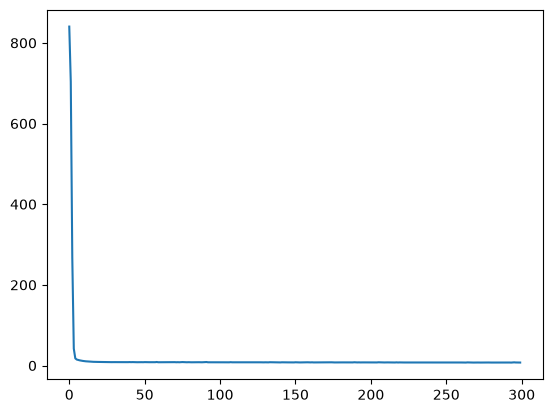
In [1]모델 정의
class RegressionModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(4, 32)
        self.fc2 = nn.Linear(32, 64)
        self.fc3 = nn.Linear(64, 16)
        self.fc4 = nn.Linear(16, 1)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = self.relu(self.fc1(x))
        x = self.relu(self.fc2(x))
        x = self.relu(self.fc3(x))
        return self.fc4(x)

device = 'cuda' if torch.cuda.is_available() else 'cpu'
model = RegressionModel().to(device)
In [2]학습 루프
criterion = nn.MSELoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
epochs = 300
loss_list = []

for epoch in range(epochs):
    loss_sum = 0
    for X_data, y_data in train_loader:
        X_data, y_data = X_data.to(device), y_data.to(device)
        optimizer.zero_grad()
        pred = model(X_data)
        loss = criterion(pred, y_data)
        loss.backward()
        optimizer.step()
        loss_sum += loss.item()
    loss_list.append(loss_sum / len(train_loader))
In [3]평가
model.eval()
with torch.no_grad():
    pred = model((X_test_tensor).to(device))

print(mean_absolute_error(y_test, pred.cpu()))
print(mean_squared_error(y_test, pred.cpu()))
print(r2_score(y_test, pred.cpu()))
Out[3] 출력 보기
2.6276835272023527
10.43576535003113
0.909453024737761
In [4]새 데이터 예측·저장
new_data = scaler.transform([[4.7, 26, 2, 0]])
pred = model(torch.tensor(new_data, dtype=torch.float32).to(device))
print(f'배달시간: {pred.item()}')

torch.save(model.state_dict(), 'Regressionmodel.pth')
joblib.dump(scaler, 'Regressionmodel_scaler.pkl')
Out[4] 출력 보기
배달시간: 18.767852783203125