← 모델 목록
수업 실습 2026-09-07 · image-classification
CNN 계열 (VGG16, ImageNet 사전학습)

torchvision vgg16 (VGG16_Weights.DEFAULT)

VGG16 전이학습 CIFAR-10 분류 (수업 실습)
모델
3×3 합성곱을 깊게 쌓은 ImageNet 사전학습 CNN. 특징 추출부(features)를 얼리고 마지막 분류층만 10개 클래스로 바꿔 학습
사용 목적
사전학습 모델을 가져와 분류기만 바꿔 쓰는 전이학습 흐름과, 데이터셋 평균·표준편차 직접 계산, 검증셋·early stopping·TensorBoard 기록을 익히려고 사용
코드
mnmms/dl
가중치
cifar10_best.pth 512MB · 로컬 보관
cifar10_best.pth (노트북 폴더 기준)
val_accuracy45.9%
학습 시간49.6분
추론 CPU / GPU측정 안 함

데이터

  • torchvision CIFAR-10 · train 40,000 · val 10,000
  • 224로 Resize · RandomCrop · 좌우 반전
  • 채널 평균·표준편차를 직접 계산해 정규화

학습

  • features 동결 · classifier[-1] 4096→10 교체
  • Adam lr 3e-3 · 배치 32 · early stop 8 에폭
  • GPU(CUDA) · 학습 약 50분

결과

  • val accuracy 0.462 (1 에폭) → 0.43 안팎
  • train accuracy 0.42 → 0.31로 오히려 하락
  • test accuracy [미확인]

배운 점

  • 학습이 진행될수록 성능이 떨어짐
  • 노트북 메모: 상위 레이어까지 학습해 보기
개요용도 의도한 용도: 전이학습(사전학습 가중치 동결 + 분류기 교체) 수업 실습 대상 사용자: 해당 없음 (학습용) 의도하지 않…

용도

  • 의도한 용도: 전이학습(사전학습 가중치 동결 + 분류기 교체) 수업 실습
  • 대상 사용자: 해당 없음 (학습용)
  • 의도하지 않은 용도: 실제 이미지 분류 (val accuracy 0.46)

모델 정보

항목 값
베이스 모델 torchvision.models.vgg16(weights=VGG16_Weights.DEFAULT) (ImageNet-1k 사전학습)
크기 · 변형 VGG16, 파라미터 약 1.34억 개 [🚩AI 설명] (torchvision 문서 기준 값, 노트북에서 세지 않음)
리비전 torchvision 0.29.0+cu126 (uv.lock 기준)
아키텍처 합성곱 13층(features, 동결) + 완전연결 3층(classifier). 마지막 층만 Linear(4096, 10)으로 교체
학습 방식 전이학습: features 동결, classifier 3층 학습 [🚩AI 설명] (동결 코드는 features만 대상이라 앞의 두 완전연결층도 학습됨)
프롬프트 · 에이전트 구성 해당 없음
데이터CIFAR-10 학습 이미지 예시 (정규화를 되돌려 표시) 확보 방식 공개 데이터셋 그대로 출처 torchvision.data…
CIFAR-10 학습 이미지 예시 (정규화를 되돌려 표시)
항목 값
확보 방식 공개 데이터셋 그대로
출처 torchvision.datasets.cifar.CIFAR10(root='./', download=True)
직접 수집 내용 해당 없음
이용 조건 확인 해당 없음 (공개 데이터셋)
규모 train 50,000 / test 10,000 (32×32 컬러)
분할 train 50,000을 8:2로 나눔: train 40,000 / val 10,000 (시드 42). test는 로더만 만들고 평가하지 않음
레이블·클래스 분포 10개 클래스 (airplane, automobile, bird, cat, deer, dog, frog, horse, ship, truck) 각 5,000장 (CIFAR-10 원본)
전처리 Resize(224) → RandomCrop(224, padding=4) → RandomHorizontalFlip(0.5) → ToTensor → Normalize(mean=(0.4914, 0.4822, 0.4465), std=(0.2470, 0.2435, 0.2616)). 평균·표준편차는 train 5만 장을 쌓아 직접 계산. test에도 같은 증강을 적용
개인정보·민감정보 처리 해당 없음
학습하이퍼파라미터 Adam(model.parameters(), lr=3e-3) , CrossEntropyLoss , 배치 32 에…
항목 값
하이퍼파라미터 Adam(model.parameters(), lr=3e-3), CrossEntropyLoss, 배치 32
에폭 / 스텝 최대 10 에폭, early stopping(patience 5, val loss 기준) → 8 에폭에서 중단
학습 시간 약 49.6분 (에폭별 tqdm 학습 시간 합: 5:57 ~ 6:46. 검증 시간 제외)
하드웨어 GPU (device 출력 'cuda'). 장비는 이 컴퓨터의 NVIDIA GeForce RTX 4070 Laptop GPU 8GB로 보이나 노트북에서 직접 확인하지는 않음 [미확인]
프레임워크 torch 2.14.0+cu126, torchvision 0.29.0, tensorboard 2.21.0
시드 · 재현 방법 train/val 분할 random_split(..., generator=torch.Generator().manual_seed(42)). 학습 시드 없음
결과학습 곡선 (TensorBoard) val 10,000장 기준, 노트북 출력과 TensorBoard 값입니다. 1 2.580 …
학습 곡선 (TensorBoard)
학습 곡선 (TensorBoard)

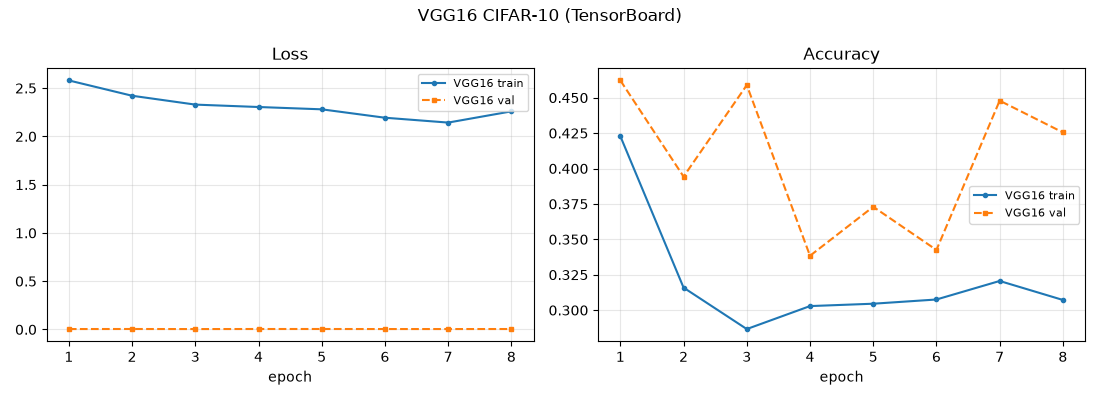
val 10,000장 기준, 노트북 출력과 TensorBoard 값입니다.

에폭 train loss train acc val acc
1 2.580 0.423 0.462
2 2.421 0.316 0.394
3 2.329 0.287 0.459 (← cifar10_best.pth)
4 2.304 0.303 0.338
5 2.280 0.305 0.373
6 2.193 0.308 0.343
7 2.143 0.321 0.448
8 2.259 0.307 0.426 (early stopping)
  • 대표 지표는 저장한 best 가중치(3 에폭)의 val accuracy 0.4589로 적었습니다. test accuracy는 재지 않음 [미확인]
  • [🚩AI 설명] val loss가 0.004 수준으로 train loss(2.3)와 단위가 다른데, 검증 루프에서 손실을 더하지 않고 마지막 배치 값으로 덮어쓴 뒤(val_loss = loss.item()) 배치 수로 나눠서입니다. 그래서 early stopping 기준이 사실상 마지막 배치 손실이었습니다.
  • [🚩AI 설명] lr 3e-3은 사전학습 분류기를 고치기에 큰 값이라 train accuracy가 1 에폭 이후 떨어진 원인 후보입니다. 확인하지는 않았습니다.

추론 성능 (CPU / GPU)

측정 안 함.

장비 장비 이름 배치 크기 지연 시간 (샘플당, p50 / p95) 처리량 (샘플/초) 메모리 사용
CPU [미확인] - 측정 안 함 측정 안 함 측정 안 함
GPU [미확인] 32 측정 안 함 (학습 중 tqdm 3.1 ~ 3.6 it/s) 측정 안 함 측정 안 함
한계 · 배운 점한계 알려진 실패 유형: 학습이 진행될수록 train accuracy가 떨어짐 (0.42 → 0.31) 편향 / 공정성 이슈:…

한계

  • 알려진 실패 유형: 학습이 진행될수록 train accuracy가 떨어짐 (0.42 → 0.31)
  • 편향 / 공정성 이슈: 해당 없음
  • 성능이 떨어지는 입력 조건: [미확인]

배운 점

  • 노트북 메모: 점차 성능이 떨어지는 것을 확인. 가중치 학습이 안 되니 상위 레이어까지 학습해 보면 됨
  • 노트북 메모: 같은 셀을 다시 실행하면 이어서 학습되므로 처음부터 다시 학습하려면 모델을 새로 만들어야 함
  • 남이 만든 모델은 학습한 이미지 크기(224)에 맞춰 리사이즈하고, 정규화 값은 데이터셋에서 직접 계산 (노트북 주석, "이 과정들이 포폴에 녹여져 있어야 함")
  • [🚩AI 설명] 이틀 뒤 Intel 이미지 미니대회에서는 lr 1e-4, 샘플 수로 손실을 누적하는 검증 루프로 바꿔 ConvNeXt로 val 0.94까지 올림 → ConvNeXt-tiny 카드
사용 방법코드 셀 3개
In [1]정규화 값 계산
data = CIFAR10(root='./', train=True, download=True, transform=ToTensor())
imgs = torch.stack([img[0] for img in data], dim=0).numpy()

print(imgs[:,0].mean(), imgs[:,1].mean(), imgs[:,2].mean())
print(imgs[:,0].std(), imgs[:,1].std(), imgs[:,2].std())
Out[1] 출력 보기
0.49139968 0.48215827 0.44653124
0.24703223 0.24348514 0.26158786
In [2]모델 준비 (동결 + 분류기 교체)
from torchvision.models import vgg16, VGG16_Weights

model = vgg16(weights=VGG16_Weights.DEFAULT)
for param in model.features.parameters():
    param.requires_grad = False
model.classifier[-1] = nn.Linear(in_features=4096, out_features=10)
In [3]학습 루프 (요약)
optim = Adam(model.parameters(), lr=3e-3)
criterion = nn.CrossEntropyLoss()
writer = SummaryWriter(log_dir='runs/cifar10')
epochs, patience = 10, 5

for epoch in range(epochs):
    model.train()
    for data, label in tqdm.tqdm(train_loader):
        optim.zero_grad()
        pred = model(data.to(device))
        loss = criterion(pred, label.to(device))
        loss.backward()
        optim.step()
    # 검증 → writer.add_scalar(...) → val_loss가 줄면 cifar10_best.pth 저장, 5번 연속 안 줄면 중단
Out[3] 출력 보기
Epoch 1 / 10
Train Loss : 2.5797
Train ACC : 0.4228
Val ACC : 0.4622
Best Model Saved!!
...
Epoch 8 / 10
Train ACC : 0.3072
Val ACC : 0.4255
Early Stopping
같은 과제·데이터셋 비교

같은 과제·데이터셋으로 학습한 모델이 생기면 여기에서 비교됩니다.