← 모델 목록
수업 실습 2026-09-09 · image-classification
CNN 계열 (ConvNeXt, 트랜스포머 설계를 가져온 CNN)

torchvision convnext_tiny (ConvNeXt_Tiny_Weights.DEFAULT)

ConvNeXt-tiny Intel 풍경 이미지 분류 (딥러닝 미니대회 · 최종 제출)
모델
ResNet 구조에 트랜스포머의 설계(큰 커널, LayerNorm, 단계 구성)를 가져와 현대화한 ImageNet 사전학습 CNN. tiny는 가장 작은 크기
사용 목적
수업 딥러닝 미니대회(Kaggle Intel Image Classification)에서 정확도를 높이려고, 분류기만 학습 → 마지막 단계 미세조정 → 규제 추가 순으로 실험
코드
mnmms/dl
가중치
best_convnext_intel_finetune.pth 106MB · 로컬 보관
best_convnext_intel_finetune.pth (노트북 폴더 기준)
test_accuracy94.4%
val_accuracy94.9%
실험3회 · 대표 r2
학습 시간56.1분
추론 CPU / GPU측정 안 함

데이터

  • Kaggle Intel 풍경 6클래스 · train 14,034 · test 3,000
  • train 11,228 · val 2,806 (무작위 8:2)
  • 224×224 · ImageNet 평균·표준편차

학습

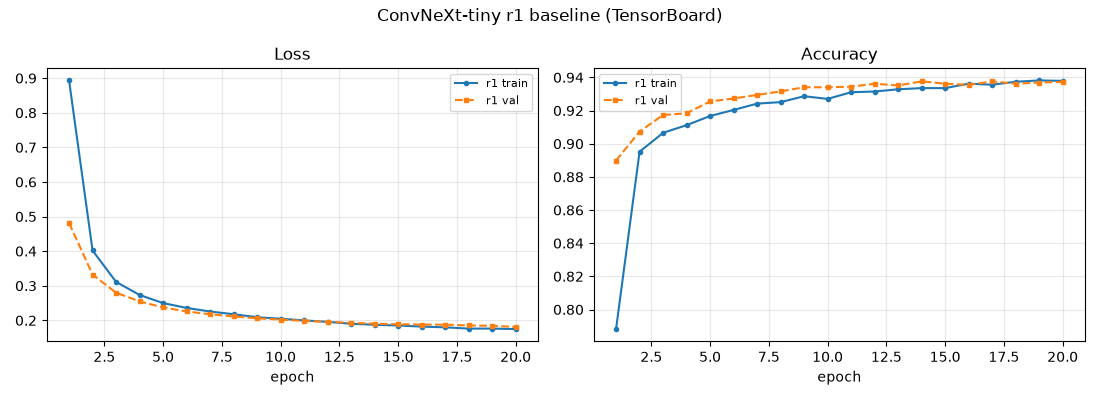
  • r1 분류기만 20 에폭 (36.8분)
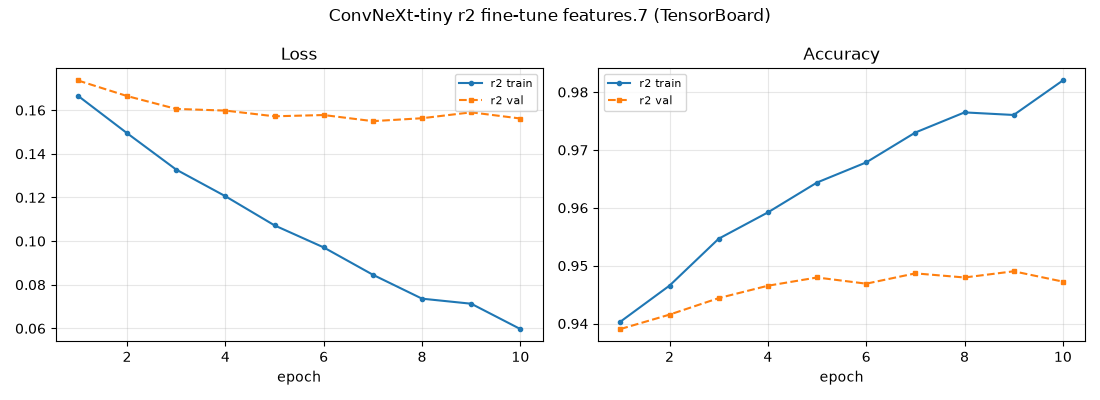
  • r2 features.7 해제 · lr 1e-5 · 10 에폭 (19.3분)
  • GPU(CUDA) · TensorBoard 기록

결과

  • val accuracy 0.937 → 0.949 (미세조정)
  • test accuracy 0.944 (최종 제출)
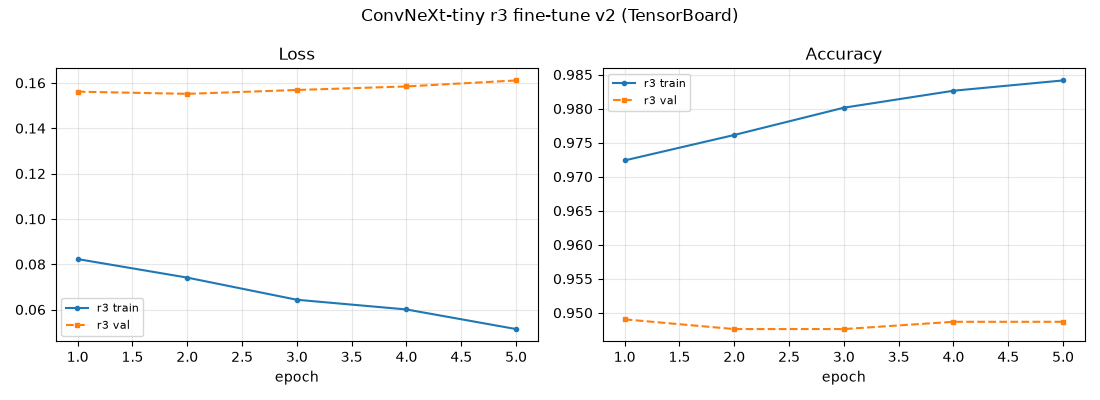
  • r3 증강 + weight decay는 개선 없음

배운 점

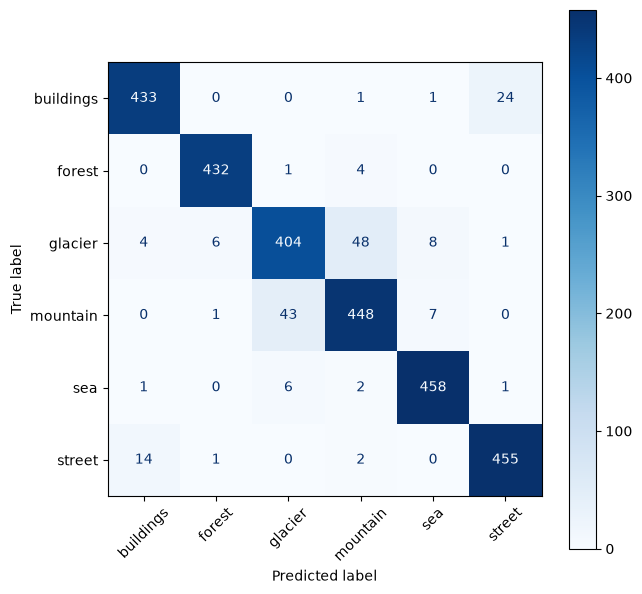
  • glacier↔mountain, buildings↔street를 헷갈림
  • train 0.98 · val 0.95 = 과적합 시작
  • 얼리고 나서 분류기 교체, 그다음 optimizer
개요용도 의도한 용도: 수업 딥러닝 미니대회 제출 (다음 날 아침 9시 마감, 슬랙에 결과·TensorBoard 스크린샷 업로드)…

용도

  • 의도한 용도: 수업 딥러닝 미니대회 제출 (다음 날 아침 9시 마감, 슬랙에 결과·TensorBoard 스크린샷 업로드)
  • 대상 사용자: 해당 없음 (학습용)
  • 의도하지 않은 용도: 6개 클래스 밖의 풍경이나 실내 사진 분류

모델 정보

항목 값
베이스 모델 torchvision.models.convnext_tiny(weights=ConvNeXt_Tiny_Weights.DEFAULT) (ImageNet-1k 사전학습)
크기 · 변형 ConvNeXt-tiny, 파라미터 약 2,860만 개 [🚩AI 설명] (torchvision 문서 기준 값, 노트북에서 세지 않음)
리비전 torchvision 0.29.0+cu126 (uv.lock 기준)
아키텍처 features 0 ~ 7 단계 → classifier(LayerNorm, Flatten, Linear(768, 6))
학습 방식 r1 분류기만 학습 → r2 features.7 + 분류기 미세조정 (2단계 전이학습)
프롬프트 · 에이전트 구성 해당 없음
데이터확보 방식 공개 데이터셋 그대로 출처 Kaggle puneet6060/intel-image-classification ( se…
항목 값
확보 방식 공개 데이터셋 그대로
출처 Kaggle puneet6060/intel-image-classification (seg_train, seg_test 사용, seg_pred는 사용 안 함)
직접 수집 내용 해당 없음
이용 조건 확인 [미확인] (Kaggle 데이터셋 라이선스를 노트북에 적지 않음)
규모 seg_train 14,034 / seg_test 3,000 (150×150 RGB)
분할 seg_train을 8:2 random_split → train 11,228 / val 2,806. test는 seg_test 3,000
레이블·클래스 분포 train: buildings 2,191 / forest 2,271 / glacier 2,404 / mountain 2,512 / sea 2,274 / street 2,382. test: 437 / 474 / 553 / 525 / 510 / 501. 최대/최소 비율 2배 안쪽이라 균형으로 판단 (노트북 Q&A)
전처리 Resize((224, 224)) → ToTensor → Normalize(ImageNet 평균·표준편차). r3만 train에 RandomHorizontalFlip
개인정보·민감정보 처리 해당 없음 (풍경 사진)
학습하이퍼파라미터 Adam , CrossEntropyLoss , 배치 32. 실행별 lr·에폭은 위 실험 기록 참고 에폭 / 스텝…
항목 값
하이퍼파라미터 Adam, CrossEntropyLoss, 배치 32. 실행별 lr·에폭은 위 실험 기록 참고
에폭 / 스텝 r1 20 에폭 (중단 없음), r2 10 에폭 (10 에폭에서 early stopping), r3 5 에폭에서 early stopping
학습 시간 r1 2,208.6초 (36.8분) + r2 1,155.4초 (19.3분) = 56.1분 (대표 r2까지). r3 609.4초 (10.2분). 모두 노트북 출력
하드웨어 GPU (cuda 출력). 장비는 이 컴퓨터의 NVIDIA GeForce RTX 4070 Laptop GPU 8GB로 보이나 노트북에서 직접 확인하지는 않음 [미확인]
프레임워크 torch 2.14.0+cu126, torchvision 0.29.0, tensorboard 2.21.0
시드 · 재현 방법 노트북의 random_split에 시드 없음 → val 구성이 재현되지 않음 (ConvNeXt-small·ResNet50 스크립트는 시드 42)
결과r1 검증셋 혼동행렬 r1 baseline 0.9373 0.1811 [미확인] 36.8분 r2 fine-tune feature…
r1 검증셋 혼동행렬
r1 검증셋 혼동행렬
실행 val accuracy (best val loss 시점) best val loss test accuracy 학습 시간
r1 baseline 0.9373 0.1811 [미확인] 36.8분
r2 fine-tune features.7 0.9487 0.1550 0.9440 19.3분
r3 fine-tune v2 0.9476 0.1552 [미확인] 10.2분
  • 최종 제출 모델은 r2 best_convnext_intel_finetune.pth: val 0.9487, test 0.9440 (노트북 결과 셀, eval_tiny_test.py)
  • 같은 test 3,000장 기준 비교: ConvNeXt-small 0.9350

추론 성능 (CPU / GPU)

측정 안 함.

장비 장비 이름 배치 크기 지연 시간 (샘플당, p50 / p95) 처리량 (샘플/초) 메모리 사용
CPU [미확인] - 측정 안 함 측정 안 함 측정 안 함
GPU [미확인] 32 측정 안 함 측정 안 함 측정 안 함
실험 기록3회 측정 · 대표 r2

같은 모델을 설정·분류기를 바꿔 3번 측정한 기록입니다. ★ r2이(가) 대표 결과(맨 위 수치)입니다.

직전 실행에서 바뀐 설정지표 최고값
실행날짜바뀐 점trainablelrepochsaugmentationweight_decaypatiencetest_accuracyval_accuracy학습 시간
r1
baseline (분류기만)
2026-09-09기준: 백본 전체 동결, classifier[-1]을 768→6으로 교체해 학습
runs_intel_img/convnext_tiny_baseline
classifier1e-420none05-93.7%36.8분
★ r2
fine-tune features.7
2026-09-09r1 가중치에서 이어서, 백본 마지막 단계(features.7)만 추가로 풀고 lr 1e-5로 미세조정
runs_intel_img/convnext_tiny_finetune
features.7 + classifier1e-510none0394.4%94.9%19.3분
r3
fine-tune v2 (증강 + weight decay)
2026-09-09r2 best(7 에폭)에서 이어서, train에 좌우 반전 증강과 weight_decay 1e-4 추가
best val loss 0.1552(2 에폭)로 r2(0.1550)보다 나아지지 않아 실패로 기록
runs_intel_img/convnext_tiny_finetune_v2
features.7 + classifier1e-510hflip1e-43-94.8%10.2분

r1 · baseline (분류기만) 기준: 백본 전체 동결, classifier[-1]을 768→6으로 교체해 학습

r1 · curves
r1 · curves
r1 · confusion-matrix-val

r2 · fine-tune features.7 r1 가중치에서 이어서, 백본 마지막 단계(features.7)만 추가로 풀고 lr 1e-5로 미세조정

r2 · curves
r2 · curves

r3 · fine-tune v2 (증강 + weight decay) r2 best(7 에폭)에서 이어서, train에 좌우 반전 증강과 weight_decay 1e-4 추가

r3 · curves
r3 · curves
한계 · 배운 점한계 알려진 실패 유형: 혼동행렬에서 glacier ↔ mountain, buildings ↔ street를 헷갈림 (노트북 …

한계

  • 알려진 실패 유형: 혼동행렬에서 glacier ↔ mountain, buildings ↔ street를 헷갈림 (노트북 메모)
  • 편향 / 공정성 이슈: 해당 없음
  • 성능이 떨어지는 입력 조건: 6개 클래스 경계에 있는 장면 (예: 건물이 있는 거리) [🚩AI 설명]
  • r2 후반 train accuracy 0.98 vs val 0.95 → 과적합 시작 (노트북 메모)

배운 점

  • 순서: 동결 → 분류기 교체 → optimizer 생성. optimizer는 requires_grad=True인 파라미터만 받음 (노트북 메모)
  • 데이터 11,228장 대비 전체를 풀면 과적합 위험이 커서 가장 상위 단계(features.7)만 풀고 lr을 1e-4 → 1e-5로 낮춤 (노트북 메모)
  • 과적합을 막으려고 레이어를 더 풀지 않고 증강 + weight decay를 넣었지만(r3) 개선 없음
  • [🚩AI 설명] 이틀 전 VGG16 CIFAR-10에서 학습이 거꾸로 갔던 것과 달리, 손실을 샘플 수로 누적해 평균 내는 검증 루프로 고쳐 val loss로 early stopping이 제대로 동작함
사용 방법코드 셀 4개
In [1]데이터 로더
full_train_dataset = ImageFolder('./dataset_intel_img_cls/seg_train', transform=transform)
test_dataset = ImageFolder('./dataset_intel_img_cls/seg_test', transform=transform)

val_size = int(len(full_train_dataset) * 0.2)
train_size = len(full_train_dataset) - val_size
train_dataset, val_dataset = random_split(full_train_dataset, [train_size, val_size])

train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
val_loader = DataLoader(val_dataset, batch_size=32, shuffle=False)
test_loader = DataLoader(test_dataset, batch_size=32, shuffle=False)
len(train_dataset), len(val_dataset), len(test_dataset), len(full_train_dataset.classes)
Out[1] 출력 보기
(11228, 2806, 3000, 6)
In [2]r1: 동결 + 분류기 교체
model = convnext_tiny(weights=ConvNeXt_Tiny_Weights.DEFAULT)
for param in model.parameters():
    param.requires_grad = False
model.classifier[-1] = nn.Linear(in_features=768, out_features=6, bias=True)

trainable_params = filter(lambda p: p.requires_grad, model.parameters())
optimizer = optim.Adam(trainable_params, lr=1e-4)
Out[2] 출력 보기
[Epoch 1/20] train_loss=0.8935 train_acc=0.7882 | val_loss=0.4816 val_acc=0.8899
...
[Epoch 20/20] train_loss=0.1749 train_acc=0.9379 | val_loss=0.1811 val_acc=0.9373
총 학습 시간: 2208.6초
In [3]r2: features.7 미세조정
for name, param in model.named_parameters():
    if name.startswith('features.7'):
        param.requires_grad = True

trainable_params = filter(lambda p: p.requires_grad, model.parameters())
optimizer = optim.Adam(trainable_params, lr=1e-5)
Out[3] 출력 보기
[FT Epoch 7/10] train_loss=0.0846 train_acc=0.9730 | val_loss=0.1550 val_acc=0.9487
...
Early stopping at epoch 10
fine-tuning 학습 시간: 1155.4초
In [4]test 평가
eval_model = convnext_tiny()
eval_model.classifier[-1] = nn.Linear(eval_model.classifier[-1].in_features, num_classes)
eval_model.load_state_dict(torch.load('best_convnext_intel_finetune.pth', map_location=device))
eval_model.to(device).eval()

correct, total = 0, 0
with torch.no_grad():
    for data, label in test_loader:
        pred = eval_model(data.to(device))
        correct += (pred.argmax(dim=1) == label.to(device)).sum().item()
        total += data.size(0)
print(f'Test Accuracy: {correct/total:.4f}')
Out[4] 출력 보기
Test Accuracy: 0.9440
같은 과제·데이터셋 비교 image-classification · Kaggle: puneet6060/intel-image-classification · 3개

굵은 이름이 이 모델입니다. 주황 테두리가 그룹 안 최고값입니다.

test_accuracy 높을수록 좋음 · 축 일부 생략