random_split(..., generator=torch.Generator().manual_seed(42)). 학습 시드 없음. python finetune_convnext_small.py로 실행
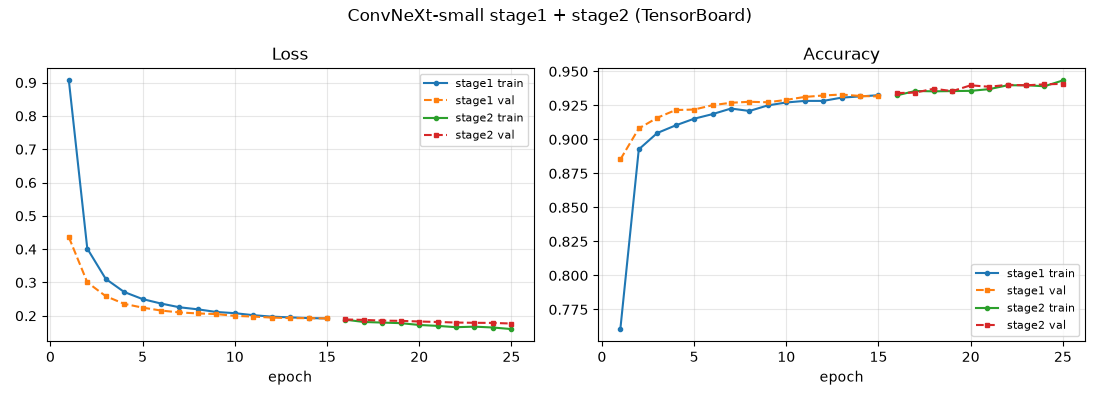
결과1단계 + 2단계 학습 곡선 (TensorBoard) test accuracy 0.9350 seg_test 3,000 0.94…
1단계 + 2단계 학습 곡선 (TensorBoard)
지표
값
테스트셋
비교 대상 (ConvNeXt-tiny r2)
test accuracy
0.9350
seg_test 3,000
0.9440
val accuracy (2단계 마지막)
0.9408
val 2,806
0.9487 (val 구성 다름)
1단계 val accuracy
0.9316 ~ 0.9330
val 2,806
추론 성능 (CPU / GPU)
측정 안 함.
장비
장비 이름
배치 크기
지연 시간 (샘플당, p50 / p95)
처리량 (샘플/초)
메모리 사용
CPU
[미확인]
-
측정 안 함
측정 안 함
측정 안 함
GPU
[미확인]
32
측정 안 함
측정 안 함
측정 안 함
한계 · 배운 점한계 알려진 실패 유형: [미확인] (혼동행렬을 그리지 않음) 편향 / 공정성 이슈: 해당 없음 성능이 떨어지는 입력 조건: …
한계
알려진 실패 유형: [미확인] (혼동행렬을 그리지 않음)
편향 / 공정성 이슈: 해당 없음
성능이 떨어지는 입력 조건: [미확인]
배운 점
wt_deep_7.ipynb "추가 비교 실험" 셀에서 옮긴 내용입니다.
2단계는 early stopping이 걸리지 않고 끝까지 개선 중이었음 (val 0.9341 → 0.9408)
tiny보다 낮은 이유는 모델이 나빠서가 아니라 낮은 lr(3e-6)과 에폭 예산 부족으로 수렴을 다 못한 것으로 판단. 더 돌리면 tiny를 넘어설 가능성 있음
시간 제약 때문에 노트북 커널과 별도로 터미널에서 백그라운드로 실행하고, 진행 상황은 finetune_small_progress.txt에 덮어써 확인
사용 방법코드 셀 2개
In [1]모델 준비 (1단계: 분류기만)
model = convnext_small(weights=ConvNeXt_Small_Weights.DEFAULT)
model.classifier[-1] = nn.Linear(model.classifier[-1].in_features, num_classes)

for param in model.parameters():
    param.requires_grad = False
for param in model.classifier.parameters():
    param.requires_grad = True
In [2]두 단계 학습
run_stage('S1-head', epochs=15, lr=1e-4, patience=4, ...)

for name, param in model.named_parameters():
    if name.startswith('features.7'):
        param.requires_grad = True

run_stage('S2-finetune', epochs=10, lr=3e-6, patience=3, ...)
Out[2] 출력 보기
[S1-head Epoch 15/15] train_loss=0.1920 train_acc=0.9325 | val_loss=0.1921 val_acc=0.9316
Stage1 done in 5026.5s
=== Stage 2: unfreeze features.7, low lr fine-tune ===
[S2-finetune Epoch 10/10] train_loss=0.1601 train_acc=0.9434 | val_loss=0.1767 val_acc=0.9408
Stage2 done in 3933.5s
FINAL TEST ACC (convnext_small) = 0.9350
같은 과제·데이터셋 비교 image-classification · Kaggle: puneet6060/intel-image-classification · 3개