In [1]전체 갤러리(6,074장) 평가
.\.venv\Scripts\python.exe analysis\single_model_comparison\dinov3\eval_dinov3.py --full-catalog| 항목 | 값 |
|---|---|
| 베이스 모델 | Hugging Face facebook/dinov3-vitl16-pretrain-lvd1689m (게이트 모델, Meta 계약 동의 + 토큰 필요) |
| 크기 · 변형 | ViT-L/16. 파라미터 수 [미확인] |
| 리비전 | revision 지정 안 함 ([미확인]) |
| 아키텍처 | AutoModel + AutoImageProcessor로 이미지 임베딩, 코사인 유사도로 순위 매김 |
| 학습 방식 | 학습하지 않음. 공식 pretrained로 임베딩만 추출 |
| 프롬프트 · 에이전트 구성 | 해당 없음 |
| 항목 | 값 |
|---|---|
| 확보 방식 | 직접 수집 (상품 사진) + 직접 그린 손그림 |
| 출처 | 오늘의집 조명 상품 사진 data/ohou_lighting_images/(갤러리), 손그림 data/hand_sketch_targets/(쿼리) |
| 직접 수집 내용 | 오늘의집 공식 API가 없어 브라우저 콘솔 스크립트(analysis/ohou_browser_collect/)로 상품 정보를 JSON으로 모으고, Claude 스킬(ohou-collect)이 그 JSON을 CSV·이미지로 만듦. 수집 기간·손그림을 그린 사람·방법은 [미확인] |
| 이용 조건 확인 | [미확인] (오늘의집 이용약관·robots.txt 확인 여부를 확인하지 않음) |
| 규모 | 갤러리 전체 카탈로그 6,074장 (--full-catalog). 초기 비교는 손그림이 있는 상품 21장만, 쿼리 손그림 72장 (초기 비교는 18장) |
| 분할 | 학습 없음(zero-shot). 쿼리 손그림 한 장당 정답 상품 사진 하나. 같은 상품을 여러 장 그린 경우 각각 독립 쿼리 |
| 레이블·클래스 분포 | 클래스 없음. 쿼리별 정답 상품 1개 (조명 전체, 장/단스탠드 라벨은 이 비교에서 쓰지 않음) |
| 전처리 | 갤러리(상품 사진)에만 선택 적용: rembg_outline(rembg 배경 제거 + Canny 외곽선), rembg_crop_outline(+ 알파 마스크 bbox 자동 크롭). 쿼리(손그림)는 전처리 없음 |
| 개인정보·민감정보 처리 | 해당 없음 |
학습을 하지 않았으므로 하이퍼파라미터·에폭·학습 시간은 해당 없음입니다.
| 항목 | 값 |
|---|---|
| 하이퍼파라미터 | 해당 없음 |
| 에폭 / 스텝 | 해당 없음 |
| 학습 시간 | 해당 없음 (임베딩 추출 시간은 [미확인]) |
| 하드웨어 | GPU 사용 (device: cuda, .venv Windows). GPU 이름은 [미확인] |
| 프레임워크 | Hugging Face transformers, PyTorch (버전 [미확인]) |
| 시드 · 재현 방법 | dinov3/eval_dinov3.py 실행. --full-catalog로 전체 갤러리, --preprocess rembg_outline 또는 rembg_crop_outline으로 갤러리 전처리 |
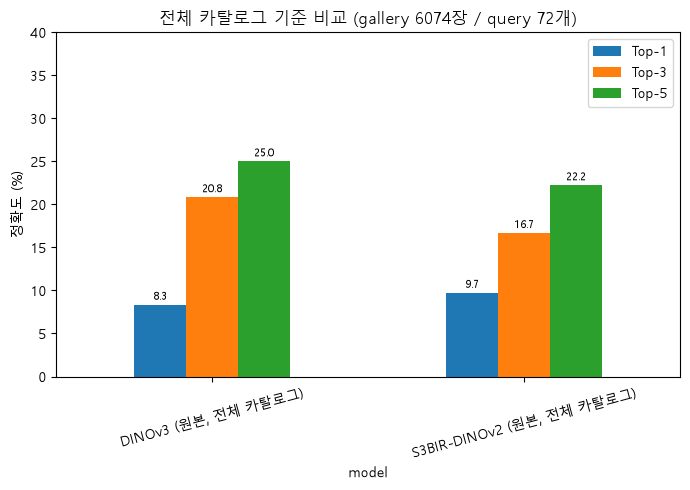
순위 = 손그림의 정답 상품이 갤러리에서 몇 번째로 유사한지. Top-k = 정답이 상위 k개에 든 쿼리 비율.
전체 갤러리 6,074장 · 쿼리 72장 (results/eval_dinov3_vitl16-pretrain-lvd1689m_full_catalog.csv)
| 지표 | 값 | 테스트셋 | 비교 대상 |
|---|---|---|---|
| Top-1 / Top-3 / Top-5 / Top-10 | 8.3% / 20.8% / 25.0% / 34.7% | 6,074장 갤러리, 쿼리 72장 | S3BIR-DINOv2 9.7% / 16.7% / 22.2% / 29.2% |
| 평균 순위 (중앙값) | 293.3 (30.5) | 〃 | S3BIR-DINOv2 333.8 (37.5) |
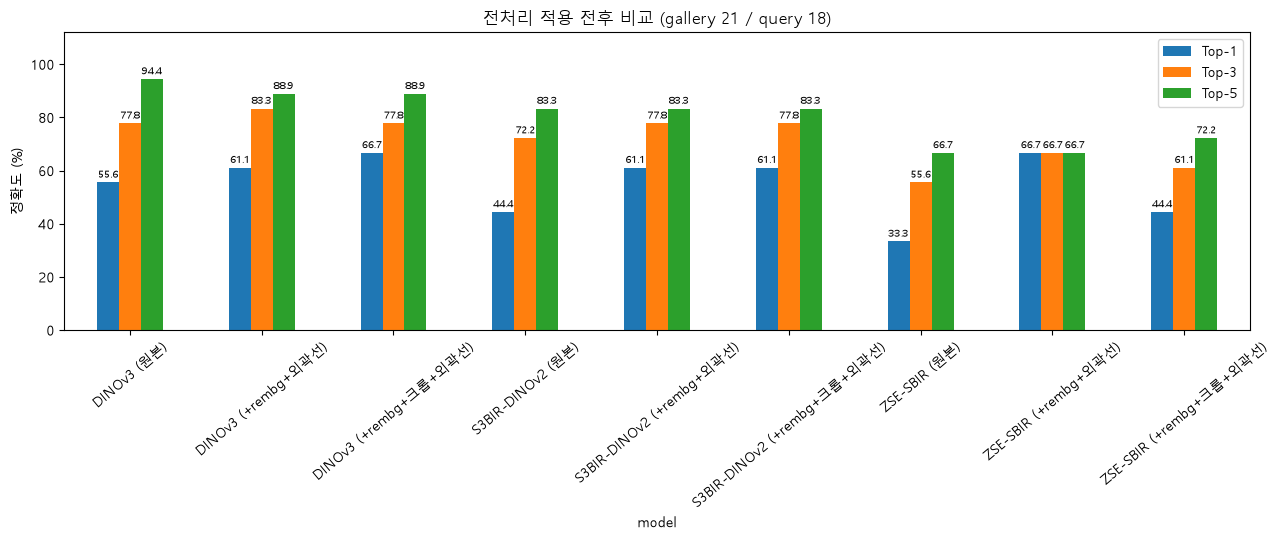
작은 갤러리 21장 · 쿼리 18장, 갤러리 전처리 비교 (model-result-1.ipynb 출력)
| 갤러리 | Top-1 | Top-3 | Top-5 | 평균 순위 |
|---|---|---|---|---|
| 원본 | 55.6% | 77.8% | 94.4% | 2.3 |
| rembg + 외곽선 | 61.1% | 83.3% | 88.9% | 2.7 |
| rembg + 크롭 + 외곽선 | 66.7% | 77.8% | 88.9% | 2.7 |
model-result-2.ipynb는 "속도 문제 해결 필요"로 남김)results/*.csv의 작은 갤러리(71장·쿼리 72장) 값은 위 18장 노트북과 쿼리 구성이 달라 따로 보면 Top-1 48.6%, 평균 순위 6.8측정 안 함. 지연 시간·처리량·메모리를 재지 않았습니다. infer_ms에는 넣지 않았습니다.
| 장비 | 장비 이름 | 배치 크기 | 지연 시간 (샘플당, p50 / p95) | 처리량 (샘플/초) | 메모리 사용 |
|---|---|---|---|---|---|
| CPU | - | - | 측정 안 함 | 측정 안 함 | 측정 안 함 |
| GPU | [미확인] | 1 (이미지 1장씩 임베딩) | 측정 안 함 | 측정 안 함 | 측정 안 함 |
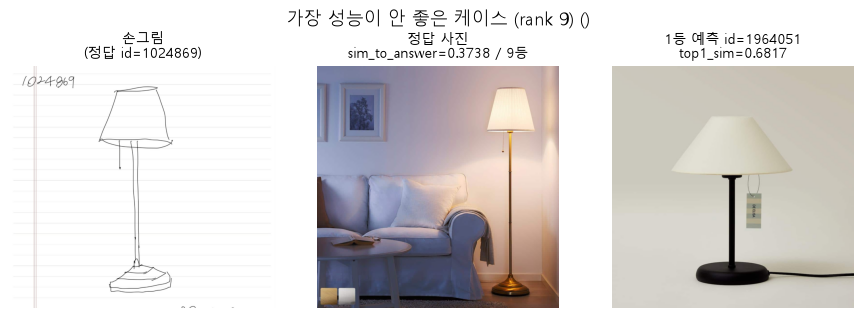
20260929-image-retrieval-furnisketch-ensemble 카드에 있음.\.venv\Scripts\python.exe analysis\single_model_comparison\dinov3\eval_dinov3.py --full-catalog.\.venv\Scripts\python.exe analysis\single_model_comparison\dinov3\eval_dinov3.py --preprocess rembg_crop_outline굵은 이름이 이 모델입니다. 주황 테두리가 그룹 안 최고값입니다.